论文链接:DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models
DeepSeek-V3.2 架构#
DeepSeek 稀疏注意力(DeepSeek Sparse Attention,DSA)#
符号约定:
| 符号 | 含义 |
|---|
| It,s | index score |
| ht∈Rd | query token |
| hs∈Rd | preceding token |
| HI | number of indexer heads |
| qt,jI∈RdI | derived from ht |
| ωt,jI∈R | derived from ht |
| ksI∈RdI | derived from hs |
当前 token 和第 s 个 token 的 index score 为:
It,s=j=1∑HIwt,jI⋅ReLU(qt,jI⋅ksI),(1)选取 Top-k index score 的历史 token 参与注意力计算:
ut=Attn(ht,{cs∣It,s∈Top−k(It;)}).(2)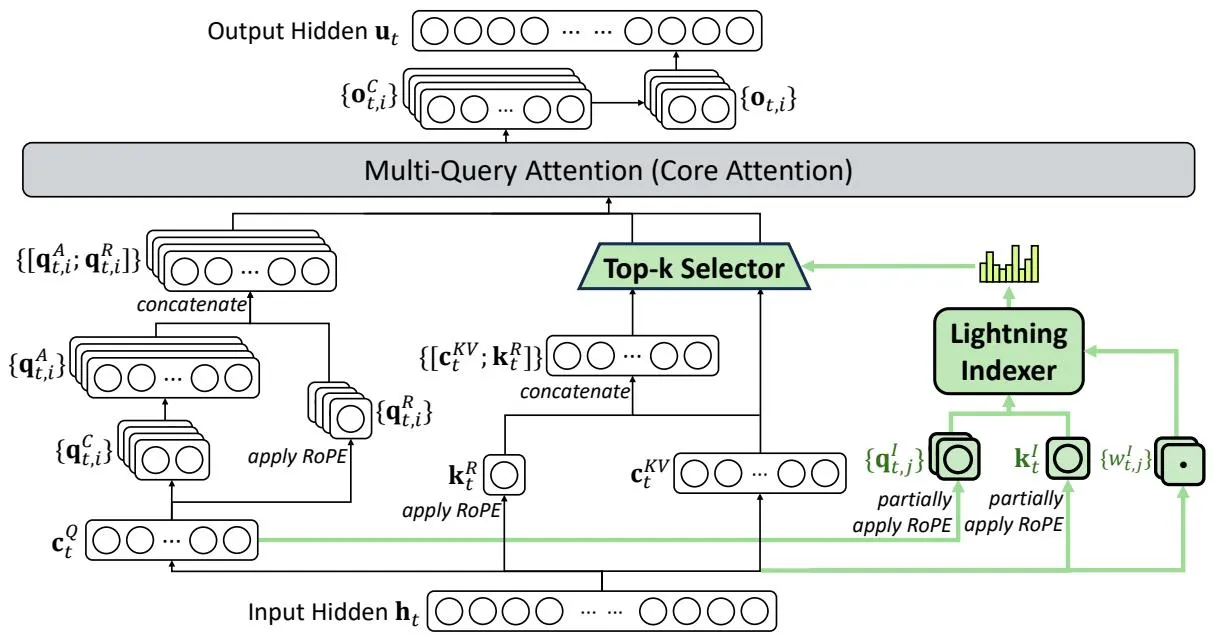 Figure 2 | DeepSeek-V3.2 的注意力架构,其中 DSA 在 MLA 下实例化。绿色部分展示了 DSA 如何根据索引器选择前k个键值条目。
复杂度:O(L2)→O(kL),其中 k≪L.
持续预训练(Continued Pre-Training)#
- 基模:DeepSeek-V3.1-Terminus 的一个检查点
- 训练设置:DeepSeek-V3.2的持续预训练由两个训练阶段组成。在这两个阶段中,训练数据的分布与用于DeepSeek-V3.1-Terminus的128K长上下文扩展数据完全对齐
稠密预热阶段(Dense Warm-up Stage)#
- 目的:初始化 lighting indexer
- 方法:保持密集注意力,并冻结所有模型参数,除了 lighting indexer。为了使索引器的输出与主要注意力分布对齐,对于第 t 个查询标记,首先通过对所有注意力头的得分进行求和来聚合主要注意力得分。然后沿序列维度对这个和进行 L1 归一化,以产生目标分布 p∗t,:∈Rt。基于 p∗t,:,将 KL 散度损失设定为索引器的训练目标:
LI=t∑DKL(pt,:∥Softmax(It,:)).(3)
| 参数 | 数值 |
|---|
| 学习率 | 10−3 |
| 步数 | 1000 |
| 每步序列数 | 16 |
| 单序列长度 | 128K |
| 总 token 数 | 21亿 |
稀疏训练阶段(Sparse Training Stage)#
- 目的:在 indexer 预热之后,引入了细粒度的 token 选择机制,并优化所有模型参数,以使模型适应 DSA 的稀疏模式
- 方法:保持将索引器输出与主要注意力分布对齐,但仅考虑所选的 token 集 St={s∣It,s∈Top−k(It;)} :
LI=t∑DKL(pt,St∥Softmax(It,St)).(4)训练时,索引器输入与计算图分离,以便进行单独优化。索引器的训练信号仅来自 LI ,而主模型的优化仅根据语言建模损失进行。
| 参数 | 数值 |
|---|
| 学习率 | 10−6 |
| 步数 | 15000 |
| 每步序列数 | 480 |
| 单序列长度 | 128K |
| 总 token 数 | 943.7B |
后训练(Post-Training)#
DeepSeek-V3.2 的后训练同样以与稀疏持续预训练阶段相同的方式采用稀疏注意力。DeepSeek-V3.2 保持与 DeepSeek-V3.2-Exp 相同的后训练流程,其中包括专家蒸馏和混合强化学习训练。
专家蒸馏#
对于每个任务,开发一个专门针对该特定领域的专用模型,所有专家模型均从同一预训练的DeepSeek-V3.2基础检查点进行微调。除了写作任务和通用问答外,该框架还涵盖六个专业领域:数学、编程、通用逻辑推理、通用智能体任务、智能体编程和智能体搜索,所有这些领域都支持思考和非思考两种模式。每个专家模型都通过大规模强化学习(RL)计算进行训练。此外,采用不同的模型来生成用于长链式思维推理(思考模式)和直接响应生成(非思考模式)的训练数据。专家模型准备就绪后,它们被用来为最终检查点生成领域特定的数据。实验结果表明,在蒸馏数据上训练的模型,其性能水平仅略低于领域特定专家模型的性能,而通过后续的强化学习训练,这一性能差距得到了有效消除。
混合RL训练#
将推理、代理和人类对齐训练合并为一个强化学习阶段。这种方法有效平衡了不同领域的表现,同时避免了多阶段训练范式中常见的灾难性遗忘问题。
- 推理和agent任务: 基于规则的结果奖励、长度惩罚和语言一致性奖励。
- 一般任务: 生成奖励模型,每个提示都有自己的评分标准。
Scaling GRPO#
DeepSeek-V3.2 的 GRPO 主要增加了无偏 KL 散度估计以及非策略序列掩码(Off-Policy Sequence Masking)。公式如下:
JGRPO(θ)=Eq∼P(Q),{oi}i=1G∼πold(⋅∣q)[G1∑i=1G∣oi∣1∑t=1∣oi∣min(ri,t(θ)A^i,t,clip(ri,t(θ),1−ε,1+ε)A^i,t)Mi,t−βDKL(πθ(oi,t)∥πref(oi,t))],(8)其中
DKL(πθ(oi,t)∥πref(oi,t))=πold(oi,t∣q,oi,<t)πθ(oi,t∣q,oi,<t)(πθ(oi,t∣q,oi,<t)πref(oi,t∣q,oi,<t)−logπθ(oi,t∣q,oi,<t)πref(oi,t∣q,oi,<t)−1),Mi,t={01A^i,t<0,∣oi∣1∑t=1∣oi∣logπθ(oi,t∣q,oi,<t)πo l d(oi,t∣q,oi,<t)>δ,o t h e r w i s e.非策略序列掩码的目的在于掩盖了引入显著策略偏差的负序列,从而稳定训练并提高对非策略更新的容忍度。