在大语言模型(LLM)的强化学习(RL)训练中,稳定性与学习效率之间永恒的拉锯战一直是研究者面临的重大挑战。阿里巴巴Qwen团队最新提出的 Soft Adaptive Policy Optimization (SAPO) 算法,通过引入软门控机制和非对称温度设计,为这一难题提供了优雅的解决方案。
本文将深入剖析SAPO的技术原理,揭示其如何通过数学上的巧妙设计,在保持稳定性的同时最大化学习效率。
问题背景:RL训练的”硬裁剪困境”
GRPO与GSPO的局限
在当前的LLM RL训练中,GRPO(Group Relative Policy Optimization)和GSPO(Group Sequence Policy Optimization)是两种主流方法,但它们都存在一个共同问题——硬裁剪(Hard Clipping)。
GRPO的核心问题:
- 在token级别进行硬裁剪
- 当重要性比率 超出 范围时,梯度被完全截断
- 这种”全有或全无”的策略导致信息损失
GSPO的困境:
- 在序列级别进行硬裁剪
- 当序列中少数token严重偏离时,整个序列的梯度被抑制
- 损失了序列中其他正常token的宝贵学习信号
WARNING在Mixture-of-Experts (MoE) 模型中,由于路由异构性,token级别的重要性比率方差更大,硬裁剪问题被进一步放大。
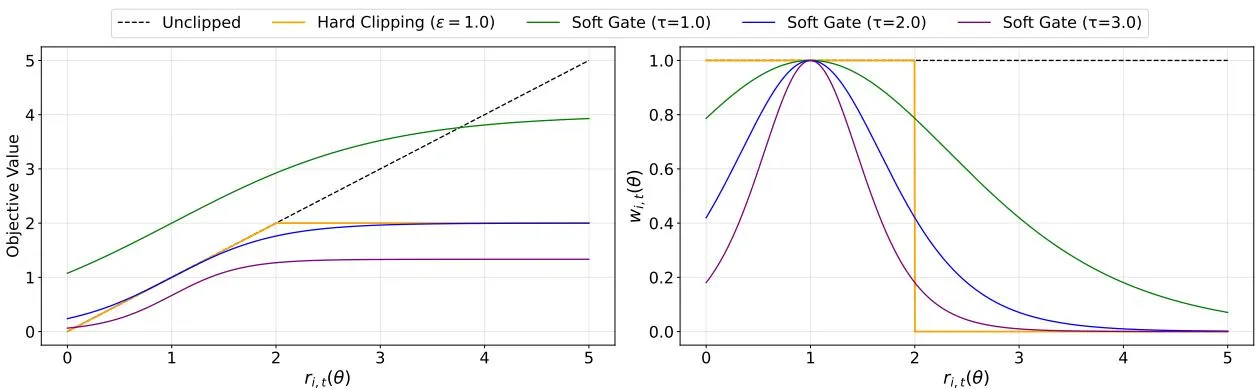
上图清晰展示了三种方法的核心差异:GRPO和GSPO使用阶梯式的硬裁剪,而SAPO采用平滑的S型门控函数。
SAPO的核心创新:软门控机制
数学 formulation
SAPO的目标函数优雅而简洁:
其中,软门控函数是SAPO的灵魂:
这里 是sigmoid函数, 是温度参数。
梯度权重分析
求导后得到梯度权重:
其中
这个权重函数具有以下关键特性:
- 在 on-policy 点(r=1)达到峰值:权重为1,保留完整梯度
- 平滑衰减:随偏离程度平滑下降,而非硬截断
- 有界性:权重始终在[0,1]范围内
TIP这个权重函数实际上是 sech² 函数的形式,在物理学中常用于描述连续过渡现象,保证了优化的平滑性。
非对称温度设计:正负token区别对待
核心洞察
SAPO的另一大创新是为正向和负向优势(advantage)设置不同的温度参数:
- 正向token():
- 负向token():
为什么需要这种不对称性?
通过数学推导可以揭示其中的奥妙。考虑logits梯度的传播:
正向优势的作用:
- 增加采样token的logit
- 减少所有未采样token的logit
负向优势的作用:
- 减少采样token的logit
- 增加大量未采样token的logit ← 问题在这里!
在大词汇表(数十万token)的场景下,负向梯度会扩散到大量不相关token,虽然提供了正则化,但也引入了严重的不稳定性。因此,我们需要让负向token的梯度更快衰减。
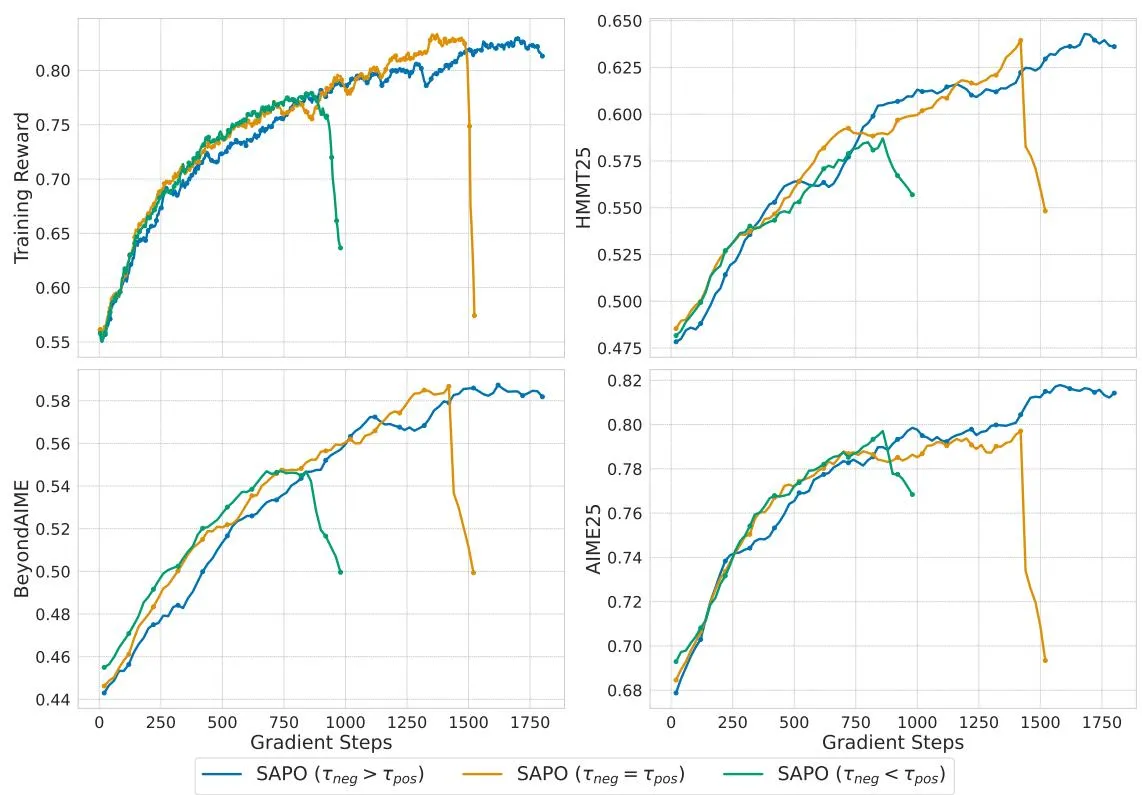
实验结果充分验证了这一设计:
- :最稳定
- :中等稳定
- :显著不稳定
理论保证:序列连贯性与token自适应性
两个关键假设
SAPO的理论分析基于两个在实际中普遍成立的假设:
(A1) 小步长假设:
- 这意味着
(A2) 低序列内方差:token级别的重要性比率在一个序列内波动不大
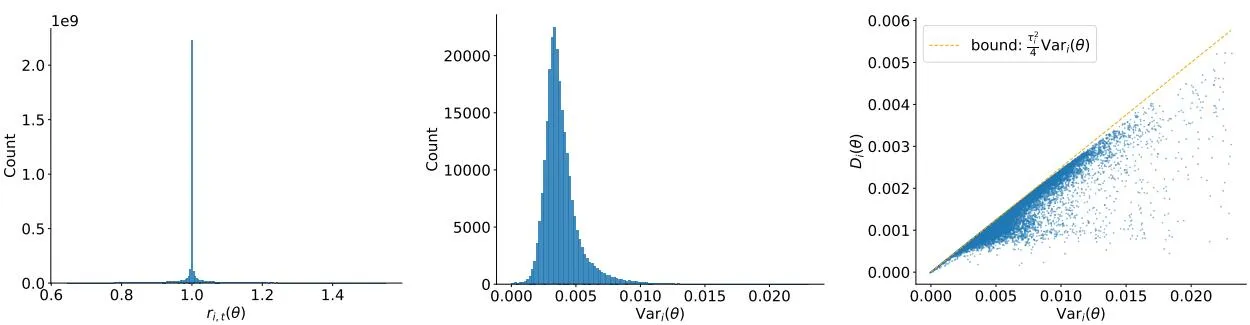
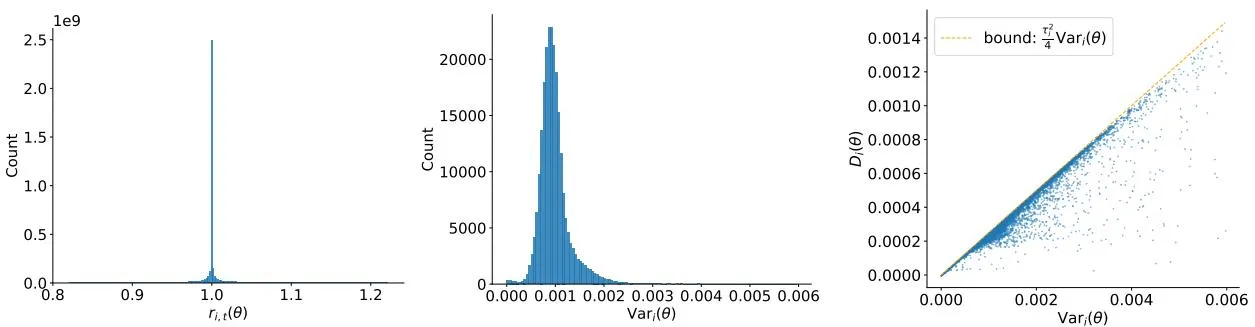
实证数据显示:
- Token比率 高度集中在1附近
- 序列内方差通常低于0.02
- MoE模型的方差略高于Dense模型(受专家路由异构性影响)
从token级到序列级的平滑过渡
在满足上述假设时,SAPO可以优雅地退化为类似GSPO的序列级更新:
更重要的是,当这些假设被违反(如出现离群token)时,SAPO会自动退回到token级门控,选择性降低离群token的权重,同时保留正常token的学习信号——这是GSPO无法做到的。
实验验证:从数学推理到大规模生产
控制实验:Qwen3-30B-A3B冷启动
在数学推理基准(AIME25、HMMT25、BeyondAIME)上的测试显示:
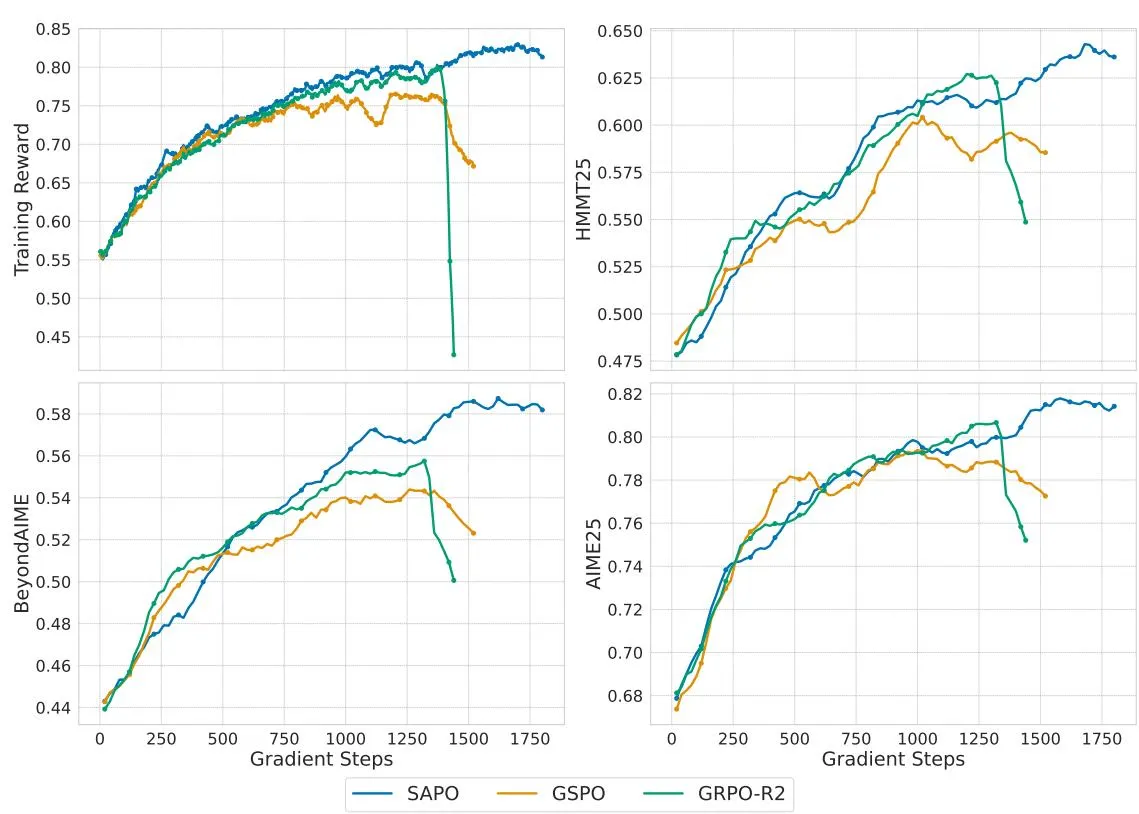
关键发现:
- 稳定性:SAPO保持持续稳定学习,而GSPO和GRPO-R2在训练早期就发生崩溃
- 最终性能:SAPO在所有基准上达到更高的Pass@1准确率
- 无需路由重放:SAPO不依赖routing replay就能实现稳定训练,简化了工程实现
大规模生产验证:Qwen3-VL系列
SAPO的真正价值在于工业级大规模训练中的验证:
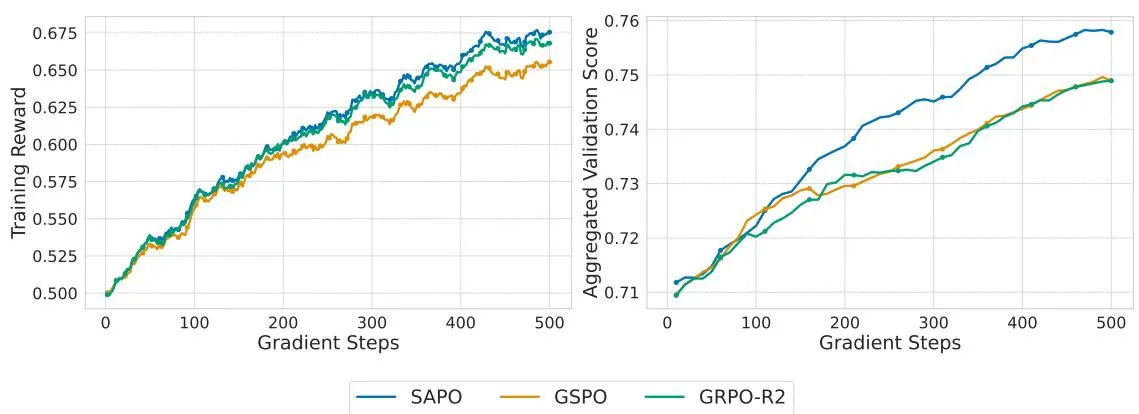
实验设置:
- 模型:Qwen3-VL-30B-A3B
- 任务:数学、编程、逻辑推理等多任务混合
- 基准:AIME25、LiveCodeBench v6、ZebraLogic、MathVision
结论:SAPO在相同计算预算下,一致性地优于GSPO和GRPO-R2,证明了其在实际生产环境中的可靠性。
实践启示:何时选择SAPO?
适用场景
✅ MoE架构模型:专家路由异构性导致的高方差问题
✅ 长序列生成:token级别方差累积更严重
✅ 多任务学习:不同任务的稳定性需求各异
✅ 大规模训练:需要长期稳定的训练动态
实施建议
-
温度参数调优:
- 起始值:,
- 根据训练稳定性动态调整
-
监控指标:
- Token级重要性比率分布
- 序列内log-ratio方差
- 梯度范数变化
-
与传统方法对比:
特性 GRPO GSPO SAPO 门控机制 硬裁剪 硬裁剪 软门控 序列连贯性 弱 强 自适应 Token级自适应性 有 无 有 超参数敏感度 中 中 低
局限性与未来方向
当前局限
⚠️ 超参数调优成本:虽然比硬裁剪稳定,但仍需针对具体任务调节温度参数
⚠️ 计算开销:软门控的指数运算比简单的阈值判断计算成本更高
⚠️ 可解释性:连续门控使得调试和分析比二元决策更复杂
未来研究方向
- 自适应温度调度:根据训练阶段动态调整温度参数
- 与探索策略结合:研究SAPO如何更好地支持高效的在线探索
- 理论深化:建立更严格的收敛性保证和样本复杂度分析
- 多模态扩展:在视觉-语言等更多模态场景中验证有效性
总结
SAPO代表了LLM强化学习训练方法的重要进步。通过软门控机制替代硬裁剪,SAPO在保持训练稳定性的同时最大化保留了学习信号;通过非对称温度设计,针对性地解决了负向更新带来的不稳定性问题。
更重要的是,SAPO不是纸上谈兵的理论创新——它已经在Qwen3-VL系列的大规模生产训练中证明了其价值,为工业界提供了一种更可靠、可扩展且高效的RL训练策略。
对于正在从事LLM RL训练的研究者和工程师,SAPO值得认真考虑作为GRPO和GSPO的替代方案。正如论文所言:
SAPO provides a more reliable, scalable, and effective optimization strategy for RL training of LLMs.
参考链接: