1065 words
5 minutes
大语言模型 On-Policy Distillation

知识蒸馏(KD)中的KL#

Geoffrey Hinton 在其 2015 年的论文Distilling the Knowledge in a Neural Network中使用了KL散度进行判别模型度知识蒸馏,形成了Supervised KL Distillation的经典范式。其训练目标函数可以写作

L=αLhard+βLsoft=(1λ)E(x,y)(X,Y)ylogqθ(1)(yx)+λT2ExXDKL(p(T)(x)qθ(T)(x))=(1λ)E(x,y)(X,Y)ylogqθ(1)(yx)+λT2ExX,yp(T)(x)logp(T)(yx)qθ(T)(yx)\begin{aligned} \mathcal{L}&=\alpha\mathcal{L}_\text{hard}+\beta\mathcal{L}_\text{soft}\\ &=-\left(1-\lambda\right)\mathbb{E}_{\left(\boldsymbol{x},\boldsymbol{y}\right)\sim\left(X,Y \right)}\boldsymbol{y}\log q_\theta^{\left(1\right)}\left(\boldsymbol{y}\mid\boldsymbol{x}\right)+\lambda T^2\mathbb{E}_{\boldsymbol{x}\sim X}D_{KL}\left(p^{\left(T\right)}\left(\cdot\mid\boldsymbol{x}\right)\Vert q_\theta^{\left(T\right)}\left(\cdot\mid\boldsymbol{x}\right)\right) \\ &=-\left(1-\lambda\right)\mathbb{E}_{\left(\boldsymbol{x},\boldsymbol{y}\right)\sim\left(X,Y\right)}\boldsymbol{y}\log q_\theta^{\left(1\right)}\left(\boldsymbol{y}\mid\boldsymbol{x}\right)+\lambda T^2\mathbb{E}_{\boldsymbol{x}\sim X, \boldsymbol{y}^*\sim p^{\left (T\right)}\left(\cdot\mid\boldsymbol{x}\right)}\log\frac{p^{\left(T\right)}\left(\boldsymbol{y}^*\mid\boldsymbol{x}\right)}{q_\theta^{\left(T\right)}\left(\boldsymbol{y}^*\mid\boldsymbol{x}\right)} \end{aligned}

其中 p(T)p^{\left(T\right)}qθ(T)q_\theta^{\left(T\right)} 分别代表教师模型和学生模型在温度 TT 下的概率。公式中对于简单的判别任务,直接在所有类别上计算KL散度,可以得到精确的数值。

GKD: On-Pollicy LLM 蒸馏#

论文 On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes将上述方法直接迁移到LLM,将传统的监督信号和LLM强化学习的On-policy生成相结合,提出了GKD(Gererative Knowledge Distillation)的训练范式。其训练目标函数可以写作

L=(1λ)E(x,y)(X,Y)1yn=1yDKL(p(y<n,x)qθ(y<n,x))+λExX,yqθ(x)1yn=1yDKL(p(y<n,x)qθ(y<n,x))=(1λ)E(x,y)(X,Y)1yn=1yEvp(y<n,x)logp(vy<n,x)qθ(vy<n,x)+λExX,yqθ(x)1yn=1yEvp(y<n,x)logp(vy<n,x)qθ(vy<n,x)\begin{aligned} \mathcal{L}&=\left(1-\lambda\right)\mathbb{E}_{\left(\boldsymbol{x},\boldsymbol{y}\right)\sim\left(X,Y\right)}\frac{1}{\lvert \boldsymbol{y}\rvert}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}D_\text{KL}\left(p\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\Vert q_\theta\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\right)\\ &+\lambda\mathbb{E}_{\boldsymbol{x}\sim X, \boldsymbol{y}^*\sim q_\theta\left(\cdot\mid\boldsymbol{x}\right)}\frac{1}{\lvert \boldsymbol{y}^*\rvert}\sum_{n=1}^{\lvert \boldsymbol{y}^*\rvert}D_\text{KL}\left(p\left(\cdot\mid \boldsymbol{y}^*_{<n},\boldsymbol{x}\right)\Vert q_\theta\left(\cdot\mid \boldsymbol{y}^*_{<n},\boldsymbol{x}\right)\right)\\ &=\left(1-\lambda\right)\mathbb{E}_{\left(\boldsymbol{x},\boldsymbol{y}\right)\sim\left(X,Y\right)}\frac{1}{\lvert \boldsymbol{y}\rvert}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}\mathbb{E}_{v\sim p\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}\log\frac{p\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{q_\theta\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}\\ &+\lambda\mathbb{E}_{\boldsymbol{x}\sim X, \boldsymbol{y}^*\sim q_\theta\left(\cdot\mid\boldsymbol{x}\right)}\frac{1}{\lvert \boldsymbol{y}^*\rvert}\sum_{n=1}^{\lvert \boldsymbol{y}^*\rvert}\mathbb{E}_{v\sim p\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}\log\frac{p\left(v\mid \boldsymbol{y}^*_{<n},\boldsymbol{x}\right)}{q_\theta\left(v\mid \boldsymbol{y}^*_{<n},\boldsymbol{x}\right)} \end{aligned}

λ=1\lambda=1 时即为 On-Policy GKD:

L=ExX,yp(x)1yn=1yDKL(p(y<n,x)qθ(y<n,x))=ExX,yp(x)1yn=1yEvp(y<n,x)logp(vy<n,x)qθ(vy<n,x)\begin{aligned} \mathcal{L}&=\mathbb{E}_{\boldsymbol{x}\sim X, \boldsymbol{y}\sim p\left(\cdot\mid\boldsymbol{x}\right)}\frac{1}{\lvert \boldsymbol{y}\rvert}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}D_\text{KL}\left(p\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\Vert q_\theta\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\right)\\ &=\mathbb{E}_{\boldsymbol{x}\sim X, \boldsymbol{y}\sim p\left(\cdot\mid\boldsymbol{x}\right)}\frac{1}{\lvert \boldsymbol{y}\rvert}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}\mathbb{E}_{v\sim p\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}\log\frac{p\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{q_\theta\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)} \end{aligned}

实际应用中,为了加快计算,常使用 Top-K 概率截断来加速计算,同时使用 K3 估计来近似计算:

L=ExX,yp(x)1yn=1yDKL(p(y<n,x)qθ(y<n,x))ExX,yp(x)1yn=1yvVtop-k(qθ(vy<n,x)p(vy<n,x)+p(vy<n,x)logp(vy<n,x)qθ(vy<n,x))\begin{aligned} \mathcal{L}&=\mathbb{E}_{\boldsymbol{x}\sim X, \boldsymbol{y}\sim p\left(\cdot\mid\boldsymbol{x}\right)}\frac{1}{\lvert \boldsymbol{y}\rvert}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}D_\text{KL}\left(p\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\Vert q_\theta\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\right)\\ &\approx\mathbb{E}_{\boldsymbol{x}\sim X, \boldsymbol{y}\sim p\left(\cdot\mid\boldsymbol{x}\right)}\frac{1}{\lvert \boldsymbol{y}\rvert}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}\sum_{v\in\mathcal{V}^\text{top-k}}\left(q_\theta\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)-p\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)+p\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\log\frac{p\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{q_\theta\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}\right) \end{aligned}

K3 估计很好地保证了在 Top-k 截断后 KL 估算的非负性。

MiniLLM: 反向 KL + 蒙特卡洛采样实现高效蒸馏#

论文 MiniLLM: Knowledge Distillation of Large Language Models提出了使用Reverse KL进行模型蒸馏。其训练目标为最小化序列级别分布的Reverse KL,可以写作

L=ExX,yqθ(x)logqθ(yx)p(yx)\begin{aligned} \mathcal{L}=\mathbb{E}_{\boldsymbol{x}\sim X, \boldsymbol{y}\sim q_\theta\left(\cdot\mid\boldsymbol{x}\right)}\log\frac{q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)}{p\left(\boldsymbol{y}\mid\boldsymbol{x}\right)} \end{aligned}

其中qθq_\theta为学生模型,pp为教师模型。

考虑其梯度:

L=ExX,yqθ(x)logqθ(yx)p(yx)=ExXy(qθ(yx)logqθ(yx)p(yx))=ExXylogqθ(yx)p(yx)qθ(yx)+ExXyqθ(yx)logqθ(yx)=ExXyqθ(yx)logqθ(yx)p(yx)logqθ(yx)+ExXyqθ(yx)logqθ(yx)=ExX,yqθ(x)(logqθ(yx)p(yx)+1)logqθ(yx)=ExX,yqθ(x)n=1y(m=1ylogqθ(ymy<m,x)p(ymy<m,x)+1)logqθ(yny<n,x)=ExX,yqθ(x)n=1y(m=nylogqθ(ymy<m,x)p(ymy<m,x)+1)logqθ(yny<n,x)\begin{aligned} \nabla\mathcal{L}&=\nabla\mathbb{E}_{\boldsymbol{x}\sim X, \boldsymbol{y}\sim q_\theta\left(\cdot\mid\boldsymbol{x}\right)}\log\frac{q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)}{p\left(\boldsymbol{y}\mid\boldsymbol{x}\right)}\\ &=\mathbb{E}_{\boldsymbol{x}\sim X}\sum_{\boldsymbol{y}}\nabla\left(q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)\log\frac{q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)}{p\left(\boldsymbol{y}\mid\boldsymbol{x}\right)}\right)\\ &=\mathbb{E}_{\boldsymbol{x}\sim X}\sum_{\boldsymbol{y}}\log\frac{q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)}{p\left(\boldsymbol{y}\mid\boldsymbol{x}\right)}\nabla q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right) +\mathbb{E}_{\boldsymbol{x}\sim X}\sum_{\boldsymbol{y}}q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)\nabla\log q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)\\ &=\mathbb{E}_{\boldsymbol{x}\sim X}\sum_{\boldsymbol{y}}q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)\log\frac{q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)}{p\left(\boldsymbol{y}\mid\boldsymbol{x}\right)}\nabla\log q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right) +\mathbb{E}_{\boldsymbol{x}\sim X}\sum_{\boldsymbol{y}}q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)\nabla\log q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)\\ &=\mathbb{E}_{\boldsymbol{x}\sim X,\boldsymbol{y}\sim q_\theta\left(\cdot\mid\boldsymbol{x}\right)}\left(\log\frac{q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)}{p\left(\boldsymbol{y}\mid\boldsymbol{x}\right)}+1\right)\nabla\log q_\theta\left(\boldsymbol{y}\mid\boldsymbol{x}\right)\\ &=\mathbb{E}_{\boldsymbol{x}\sim X,\boldsymbol{y}\sim q_\theta\left(\cdot\mid\boldsymbol{x}\right)}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}\left(\sum_{m=1}^{\lvert \boldsymbol{y}\rvert}\log\frac{q_\theta\left(y_m\mid \boldsymbol{y}_{<m},\boldsymbol{x}\right)}{p\left(y_m\mid \boldsymbol{y}_{<m},\boldsymbol{x}\right)}+1\right)\nabla\log q_\theta\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\\ &=\mathbb{E}_{\boldsymbol{x}\sim X,\boldsymbol{y}\sim q_\theta\left(\cdot\mid\boldsymbol{x}\right)}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}\left(\sum_{m=n}^{\lvert \boldsymbol{y}\rvert}\log\frac{q_\theta\left(y_m\mid \boldsymbol{y}_{<m},\boldsymbol{x}\right)}{p\left(y_m\mid \boldsymbol{y}_{<m},\boldsymbol{x}\right)}+1\right)\nabla\log q_\theta\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\\ \end{aligned}

可以发现梯度可以写成策略梯度的形式。因此可以使用强化学习的方法,通过蒙特卡洛采样的方式估计梯度。

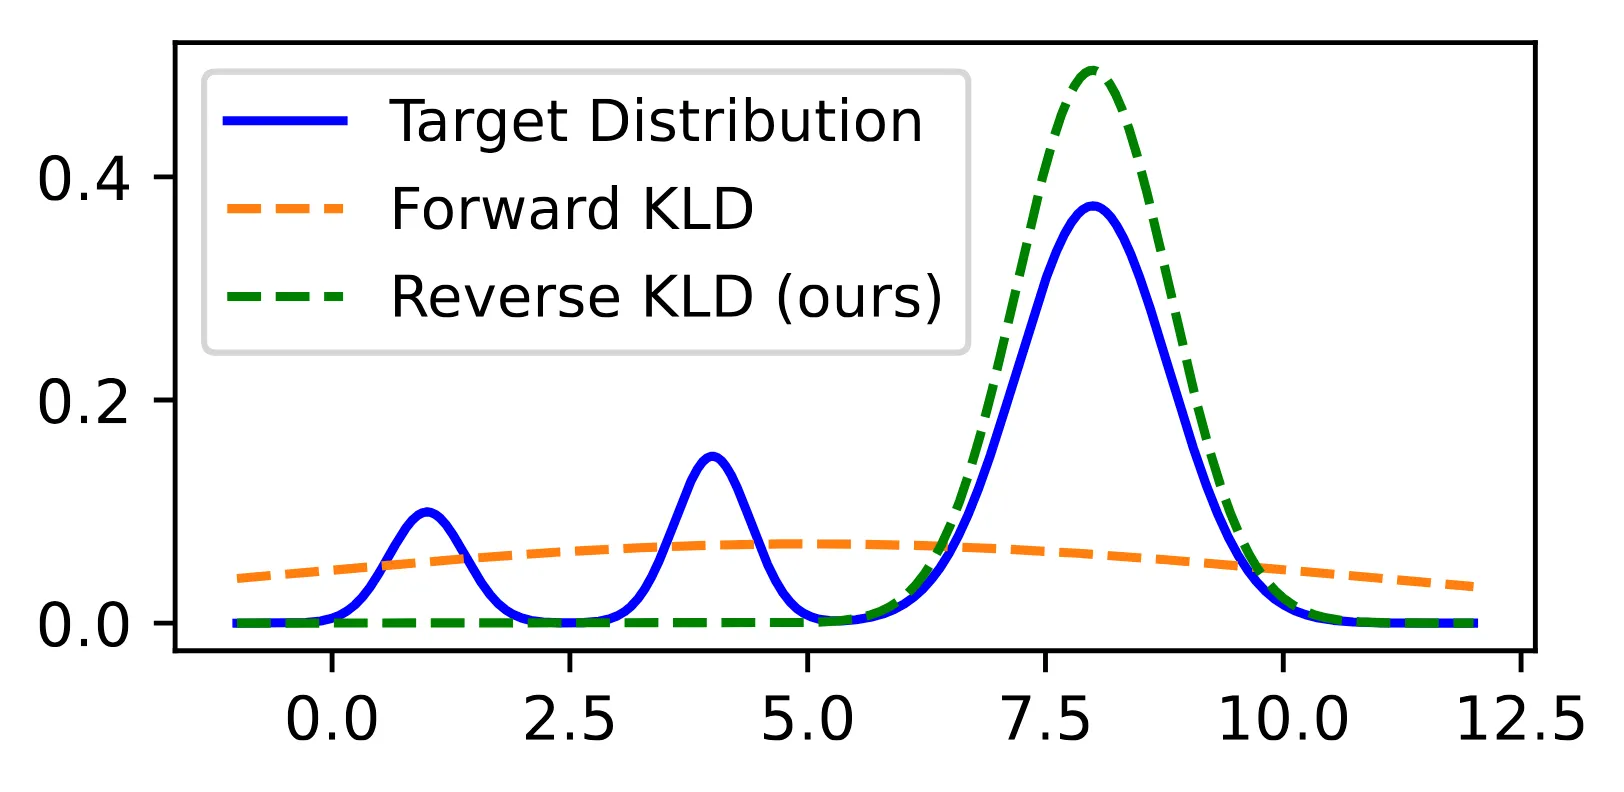
Reverse KL的主要优势如下图所示,学生模型不会尝试拟合教师的完整分布,而是去拟合和学生模型分布相近的一个子分布。该特点使得蒸馏后学生模型不容易损失原有的能力。
蒙特卡洛采样会引入极大的方差,在整个 sequence 级别计算 KL 还会使方差累积。因此,当前更常见的方法是仅优化单步的 KL 损失,即

L=ExX,yqθ(x)n=1yEynqθ(y<n,x)logqθ(yny<n,x)p(yny<n,x)\begin{aligned} \mathcal{L}=\mathbb{E}_{\boldsymbol{x}\sim X,\boldsymbol{y}\sim q_\theta(\cdot\mid\boldsymbol{x})}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}\mathbb{E}_{y^*_n\sim q_\theta\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}\log\frac{q_\theta\left(y^*_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{p\left(y^*_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}\\ \end{aligned}

其梯度为

L=n1ExX,yqθ(x)Eynqθ(y<n,x)1{yn}(logqθ(yny<n,x)p(yny<n,x)1)logqθ(yny<n,x)=n1ExX,y<nqθ(x)Eynqθ(y<n,x)1{y<n=n1}(logqθ(yny<n,x)p(yny<n,x)1)logqθ(yny<n,x)=n1ExX,ynqθ(x)1{yn=n}(logqθ(yny<n,x)p(yny<n,x)1)logqθ(yny<n,x)=n1ExX,yqθ(x)1{yn}(logqθ(yny<n,x)p(yny<n,x)1)logqθ(yny<n,x)=ExX,yqθ(x)n=1y(logqθ(yny<n,x)p(yny<n,x)1)logqθ(yny<n,x)=ExX,yqθ(x)n=1ylogqθ(yny<n,x)p(yny<n,x)logqθ(yny<n,x)\begin{aligned} \nabla\mathcal{L}&=\sum_{n\geqslant 1}\mathbb{E}_{\boldsymbol{x}\sim X,\boldsymbol{y}\sim q_\theta(\cdot\mid\boldsymbol{x})}\mathbb{E}_{y^*_n\sim q_\theta\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}\mathbf 1\left\{\lvert \boldsymbol{y}\rvert\geqslant n\right\}\left(\log\frac{q_\theta\left(y^*_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{p\left(y^*_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}-1\right)\nabla\log q_\theta\left(y^*_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\\ &=\sum_{n\geqslant 1}\mathbb{E}_{\boldsymbol{x}\sim X,\boldsymbol{y}_{<n}\sim q_\theta(\cdot\mid\boldsymbol{x})}\mathbb{E}_{y^*_n\sim q_\theta\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}\mathbf 1\left\{\lvert \boldsymbol{y}_{<n}\rvert=n-1\right\}\left(\log\frac{q_\theta\left(y^*_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{p\left(y^*_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}-1\right)\nabla\log q_\theta\left(y^*_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\\ &=\sum_{n\geqslant 1}\mathbb{E}_{\boldsymbol{x}\sim X,\boldsymbol{y}_{\leqslant n}\sim q_\theta(\cdot\mid\boldsymbol{x})}\mathbf 1\left\{\lvert \boldsymbol{y}_{\leqslant n}\rvert=n\right\}\left(\log\frac{q_\theta\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{p\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}-1\right)\nabla\log q_\theta\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\\ &=\sum_{n\geqslant 1}\mathbb{E}_{\boldsymbol{x}\sim X,\boldsymbol{y}\sim q_\theta(\cdot\mid\boldsymbol{x})}\mathbf 1\left\{\lvert \boldsymbol{y}\rvert\geqslant n\right\}\left(\log\frac{q_\theta\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{p\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}-1\right)\nabla\log q_\theta\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\\ &=\mathbb{E}_{\boldsymbol{x}\sim X,\boldsymbol{y}\sim q_\theta(\cdot\mid\boldsymbol{x})}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}\left(\log\frac{q_\theta\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{p\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}-1\right)\nabla\log q_\theta\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\\ &=\mathbb{E}_{\boldsymbol{x}\sim X,\boldsymbol{y}\sim q_\theta(\cdot\mid\boldsymbol{x})}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}\log\frac{q_\theta\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{p\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}\nabla\log q_\theta\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\\ \end{aligned}

因此可以直接将 logqθ(yny<n,x)p(yny<n,x)\log\frac{q_\theta\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{p\left(y_n\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)} 作为强化学习的 Advantage 进行训练。

GLM-5: On-Policy 多阶段蒸馏#

GLM-5 的技术报告 GLM-5: from Vibe Coding to Agentic Engineering 将 MiniLLM 的 On-Policy Distillation 引入模型自蒸馏中。自蒸馏的模型来自学生模型进行多阶段 RL 训练后得到的检查点。通过这种方式,学生模型通过密集奖励同时学习多个专家模型的分布,实现多任务的泛化能力。

DeepSeek-V4: 全词表精确反向 KL 计算#

DeepSeek-V4的技术报告 DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence 中提到了 DeepSeek-V4 在全词表上计算反向 KL 以实现精确的数值计算,即

L=ExX,yp(x)1yn=1yDKL(qθ(y<n,x)p(y<n,x))=ExX,yp(x)1yn=1yvVqθ(vy<n,x)logqθ(vy<n,x)p(vy<n,x)\begin{aligned} \mathcal{L}&=\mathbb{E}_{\boldsymbol{x}\sim X, \boldsymbol{y}\sim p\left(\cdot\mid\boldsymbol{x}\right)}\frac{1}{\lvert \boldsymbol{y}\rvert}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}D_\text{KL}\left(q_\theta\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\Vert p\left(\cdot\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\right)\\ &=\mathbb{E}_{\boldsymbol{x}\sim X, \boldsymbol{y}\sim p\left(\cdot\mid\boldsymbol{x}\right)}\frac{1}{\lvert \boldsymbol{y}\rvert}\sum_{n=1}^{\lvert \boldsymbol{y}\rvert}\sum_{v\in\mathcal{V}}q_\theta\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)\log\frac{q_\theta\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)}{p\left(v\mid \boldsymbol{y}_{<n},\boldsymbol{x}\right)} \end{aligned}

这在超大参数量、多教师模型以及超长上下文的推理场景下造成了极大的性能挑战。为了解决这个问题,DeepSeek-V4 在 OPD 训练阶段将教师权重全部卸载至集中式分布式存储中,并在教师前向传播期间按需加载,采用类似 ZeRO 的参数分片技术以缓解 I/O 与 DRAM 压力。此外,在教师模型前向传播中缓存最后一层 hidden state 并在训练中重新复原 logits,避免显式实例化 logits 带来极大的内存负担。
大语言模型 On-Policy Distillation
https://etherwindy.github.io/AstroBlog/posts/kl-llm/
Author
etherwindy
Published at
2026-05-13
License
CC BY-NC-SA 4.0